NVIDIAが、家庭内ネットワークにある複数のPCをローカルAI処理に活用する「NVIDIA Personal AI Router(PAIR)」のβ版を公開しました。
PAIRは、OllamaやLM Studioで発生する複数の独立したAI推論リクエストを、その時点で処理できるPCへ自動的に振り分ける仕組みです。NVIDIAのデモでは、5つのサブエージェントを使う同一タスクが、1台では平均18分だったのに対し、3台構成では8分48秒まで短縮されました。
ただし、3台のGPUやVRAMを合体させて「1台の巨大GPU」にする技術ではありません。
この違いを理解すると、PAIRが役立つ環境と、PCを増やしてもあまり速くならない使い方が見えてきます。
PAIRは「GPUを束ねる」のではなく、仕事を振り分ける
PAIRの役割は、名前の通り「Router」です。
家庭内LANに参加しているPCを検出し、
- そのPCがオンラインか
- OllamaまたはLM Studioが動作しているか
- 要求されたモデルを持っているか
- 現在どの程度処理を抱えているか
- GPUが他の処理で使われているか
といった情報を見ながら、新しい推論リクエストを処理できるノードへ振り分けます。
アプリ側からは基本的にPAIRのローカルエンドポイントへ接続するだけで、実際にどのPCが処理したかをPAIR側が管理します。
つまりイメージとしては、「複数GPUを合体させる」のではなく、複数のAI処理を別々のPCへ割り当てるロードバランサーに近い仕組みです。
3台構成では18分→8分48秒
NVIDIAが紹介しているデモでは、Hermes Desktopが5つのサブエージェントを起動し、Ollama上のQwen 3.6 35B A3Bを使って処理しています。
比較結果は次の通りです。
| 構成 | 平均処理時間 |
|---|---|
| RTX Spark搭載ノートPC 1台 | 18分 |
| RTX Spark搭載ノートPC+DGX Spark+RTX 5090 | 8分48秒 |
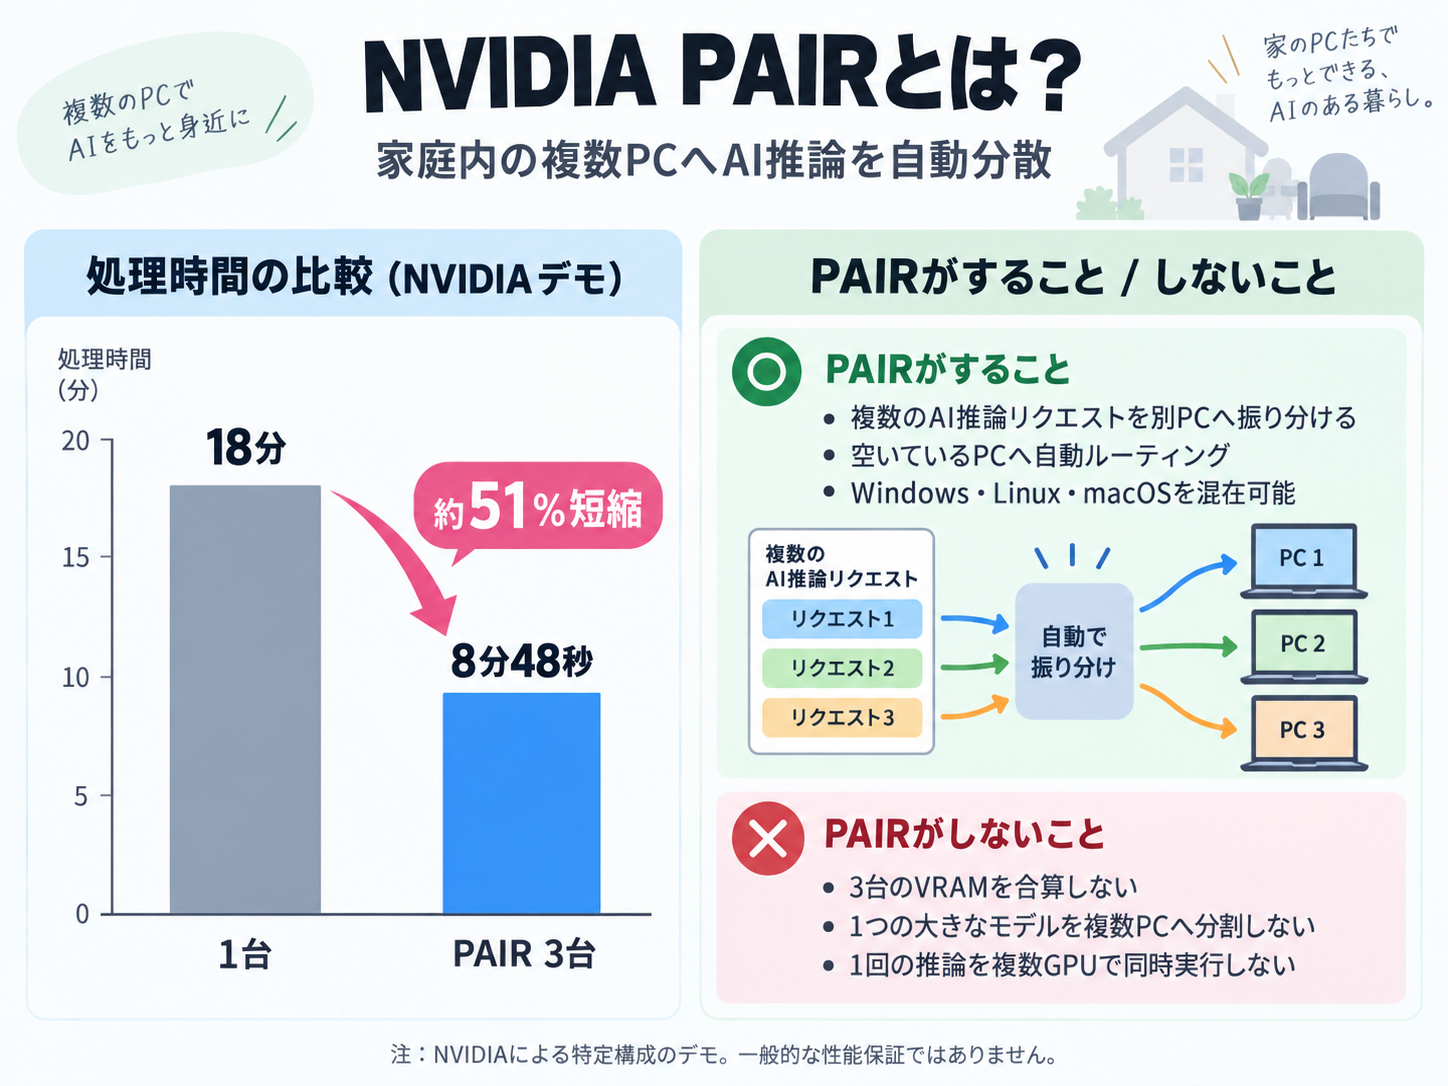
処理時間だけを見ると約51%短縮されていますが、ここは注意が必要です。
NVIDIA自身も、これは特定構成で行った非公式デモであり、一般的な性能ベンチマークや台数に比例した高速化を保証するものではないと説明しています。
速くなった理由は、1つの推論を3台で分割したからではありません。
5つのサブエージェントから発生する複数の推論要求を並列に処理し、1台のGPUで順番待ちする時間を減らしたことが大きなポイントです。
「家にPCが3台ある」だけでは速くならない
PAIRが特に効果を発揮するのは、同時に複数の推論要求が発生する処理です。
例えば、
- 複数のAIエージェントを同時実行する
- コーディング、調査、検証などを複数のサブエージェントへ分ける
- 複数のローカルAIアプリを同時に使う
といったケースです。
反対に、1回の長い推論を順番に処理するだけなら、PCを増やしても高速化の余地は小さくなります。
PAIRは1つのリクエストを途中で分割しません。1件の推論は最初から最後まで選ばれた1台で処理されます。
そのため、
| 期待すること | PAIR |
|---|---|
| 複数のAI処理を別PCで並列実行 | ○ |
| 空いているPCへ自動振り分け | ○ |
| Windows・Linux・macOSを混在 | ○ |
| 3台のVRAMを合算 | × |
| 1つの巨大モデルを複数PCへ分割 | × |
| 1回の推論を複数GPUで高速化 | × |
という整理になります。
「8GBのGPUを3枚使えば24GB VRAMとして24GB必要なモデルが動く」という使い方はできません。
Windows・Linux・Macを混在できる
PAIRのGitHubドキュメントでは、Windows 11、Linux、macOSをサポートし、x64とarm64に対応しています。異なるOSのPCを同じクラスタへ参加させることもできます。
なお、Windows on ARMは現時点でexperimental(実験的対応)とされています。
対応する推論エンジンは、現時点ではOllamaとLM Studioです。
NVIDIAが案内する対応ハードウェアには、
- GeForce RTX 20シリーズ以降
- DGX Spark / GB10
- Apple M4以降
などが含まれています。
一方、PAIRそのものが動くことと、そのPCで希望するAIモデルを推論できることは別です。
各PCには、使うモデルを単独でロードできるだけのメモリが必要になります。モデルを持っていないPCや、対応する推論エンジンが動いていないPCは、そのリクエストの処理先にはなりません。
GitHubではオープンソースとして公開されており、2026年9月6日時点の最新リリースはv0.1.1です。Windows用インストーラー、Linux用Debianパッケージ、macOS用ディスクイメージなどが用意されています。
「余っているPCを使いたい」という需要とは相性がいい
Redditのr/LocalLLaMAでも、PAIRを「Personal AI Cluster」と紹介した投稿に関連した議論が出ています。
2026年9月6日時点では31スコアと大規模な反応ではありませんが、「クラスタ」という言葉からGPUやVRAMを束ねる機能だと受け取ると誤解になる、という指摘が見られます。
実際のコメントでも、「大きなモデルを動かすためにマシンを束ねるものではなく、ネットワーク上の別マシンへリクエストを配るルーターだ」という整理がされています。
ここはPAIRを見るうえで一番重要なポイントでしょう。
GPU性能が低すぎる古いPCまで何でも計算資源に変えられるわけではありませんが、すでにRTX搭載PCやMacなどを複数持っている家庭なら、使っていない時間の計算資源を活用できる可能性があります。
特にローカルAIが「1人で1つのチャットを動かす」用途から、複数エージェントが同時に動く用途へ広がれば、こうした家庭内の分散処理は今より意味を持ちそうです。
参照したネット反応
- Reddit r/LocalLLaMA「NVIDIA PAIR — Your Personal AI Cluster」 — 31スコア(2026年9月6日確認)
参照した一次情報
- 発表元:NVIDIA
- 発表元:NVIDIA
- 資料名:NVIDIA Personal AI Router (PAIR) 公式ページ
- 確認日:2026年9月6日
- 発表元:NVIDIA
- 資料名:NVIDIA Personal AI Router GitHubリポジトリ
- 確認日:2026年9月6日