Sony Music PublishingやWarner Chappell Musicなど音楽出版社35社が、生成AI「Claude」を開発するAnthropicと共同創業者2人を著作権侵害で提訴しました。
原告側は、Anthropicが数万曲に及ぶ著作権保護された楽曲を無断で取得し、Claudeの学習などに利用したと主張しています。
1作品について最大15万ドルの法定損害賠償なども求めており、大型のAI著作権訴訟になりそうです。
ただし、このニュースを単純に、
「著作物をAIに学習させたから訴えられた」
と理解すると、少し本質を見誤ります。
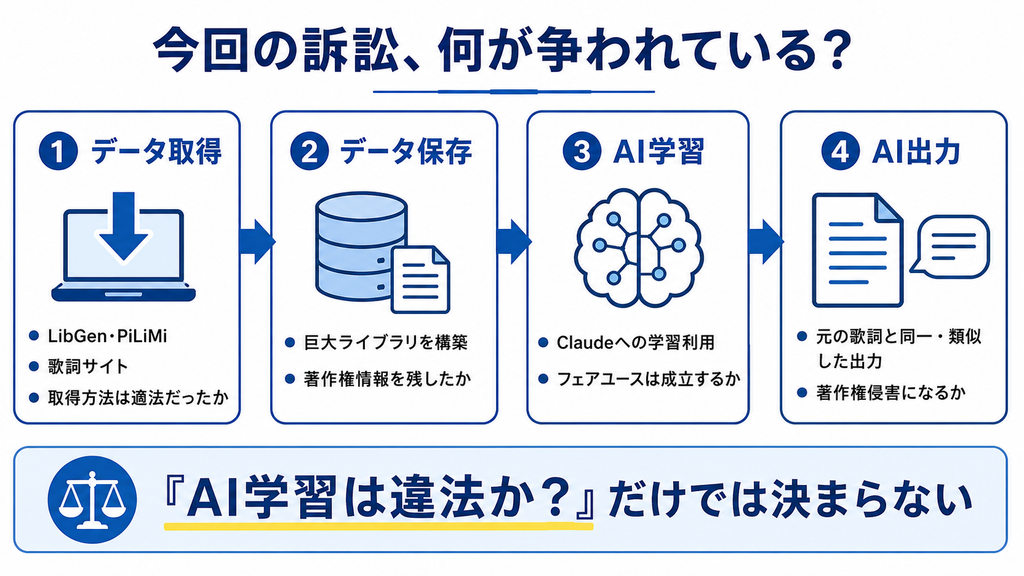
48ページに及ぶ訴状を見ると、原告が問題にしているのは「学習」だけではなく、海賊版サイトからの取得、歌詞サイトからのスクレイピング、著作権情報の除去、Claudeによる出力まで複数段階に分かれています。
ソニー系・ワーナー系など35社が提訴
訴訟は8月28日、米カリフォルニア州北部地区連邦地裁に提起されました。
原告にはSony Music Publishing (US)、Warner Chappell Musicのほか、EMIやHipgnosis、Jobeteなど多数の音楽出版社・権利管理会社が名を連ねています。
被告は、
- Anthropic
- CEOのダリオ・アモデイ氏
- 共同創業者ベンジャミン・マン氏
の3者です。
企業だけでなく創業者個人も被告になっている点が特徴です。
訴状では、Anthropic側が著作権で保護された「数千、数万規模」の楽曲を取得し、Claudeの開発や運用に利用したと主張しています。
例として挙げられているのは、
- 「Ain’t No Mountain High Enough」
- 「All I Want for Christmas Is You」
- 「Eye of the Tiger」
- 「Livin’ On a Prayer」
- 「September」
- 「Hallelujah」
などの著名曲です。
もちろん、現段階ではこれらは原告側の主張です。
裁判所が今回の著作権侵害を認定したわけではありません。
700万冊超の「海賊版書籍」が再び焦点に
今回の訴訟を理解する上で重要なのが、Anthropicが過去に構築した書籍データベースです。
訴状によると、2021年にマン氏がBitTorrentを利用し、海賊版電子図書館「Library Genesis(LibGen)」から少なくとも500万冊を取得。
2022年には「Pirate Library Mirror(PiLiMi)」から、さらに少なくとも200万冊を取得したとされています。
合計すると700万冊以上です。
その中には、歌詞や楽譜を収録した書籍も含まれていたというのが今回の音楽出版社側の主張です。
これは完全な新事実というわけではありません。
作家らがAnthropicを訴えた「Bartz v. Anthropic」では、同社による海賊版書籍の大量取得がすでに問題になっていました。
そして、この過去の裁判が今回のニュースを読み解くうえで非常に重要です。
「AI学習」と「海賊版を入手すること」は別問題
2025年のBartz訴訟で裁判所は、かなり興味深い判断を示しています。
著作物をLLMの学習に利用すること自体については、非常に変容的な利用であり、対象となった学習行為についてフェアユースが成立すると判断しました。
一方で、
海賊版サイトから何百万冊もダウンロードして恒久的なライブラリを作ること
については、同じフェアユースとは認めませんでした。
つまり、
| 行為 | 過去のBartz訴訟での扱い |
|---|---|
| 書籍をLLMの学習に利用 | 対象となった利用はフェアユース |
| 購入した紙の本をデジタル化 | 対象となった利用はフェアユース |
| 海賊版サイトから大量取得 | フェアユースとは認めず |
| 今回の歌詞利用 | 新しい訴訟で争われる |
という構図です。
その後Anthropicは作家側と15億ドルで和解し、2026年7月に裁判所が最終承認しています。
そのため今回の音楽出版社側も、単純に「AIに学習させた」だけではなく、
そもそも学習データをどこから、どのような方法で取得したのか
を強く攻めています。
歌詞サイトからのスクレイピングも問題視
今回の訴状には、海賊版書籍とは別の取得ルートも書かれています。
原告側はAnthropicが、歌詞を正式にライセンスして提供しているMusixMatchやLyricFindなどのサービスからも歌詞をスクレイピングしたと主張しています。
ここも重要です。
例えば人間がWebサイトを閲覧できることと、そのサイトに掲載されたコンテンツを大量に取得して別サービスの学習データへ利用できることは同じではありません。
原告側から見れば、
「自分たちはライセンス料を支払って歌詞を提供しているのに、そのデータをAI企業が無断で大量取得すればライセンス市場が成立しない」
という理屈になります。
Anthropic側がこれにどう反論するのかは、今後の裁判で注目されるところです。
今回は「学習」だけでなくClaudeの出力も争点
もう一つ、今回の訴訟が単なるAI学習訴訟ではない理由があります。
原告側は、Claudeが著作権で保護された歌詞と同一または非常に近い文章を出力する場合があるとも主張しています。
つまり争点は、
① データをどう取得したか
↓
② 学習に使うことは許されるのか
↓
③ Claudeが何を出力するのか
の3段階にまたがっています。
さらに訴状では、Webページから取得する際に著作権表示などの「著作権管理情報」を除去したとして、米著作権法に基づく追加の請求も行われています。
「AI学習のフェアユース」だけで勝敗が決まる訴訟ではないわけです。
1曲「最大15万ドル」は、そのまま賠償額ではない
報道で目立つのが、
「1作品あたり最大15万ドル」
という数字です。
米国著作権法では、故意の著作権侵害と認定された場合、法定損害賠償が1作品あたり最大15万ドルになる場合があります。
ただし、
提訴された時点で15万ドル×全作品の支払いが決まったわけではありません。
裁判では、
- 実際にどの作品が利用されたか
- 著作権侵害が成立するか
- フェアユースが成立する部分はあるか
- 故意だったと認定されるか
- どの請求について損害賠償が認められるか
などが争われます。
現時点で「Anthropicに数十億ドルの賠償が確定」といった理解は早すぎます。
Anthropicも出版社側の主張には同意せず、法廷で争う方針を示しています。
Redditでは1万2000票超、AI利用者からも厳しい声
今回の訴訟はネット上でも大きな反応を集めています。
Redditの「r/technology」で訴訟を紹介した投稿は、8月31日確認時点で1万2000票を超える評価を集めています。
目立つのは、単純な「AI対著作権者」という対立だけではありません。
「AI企業は最初から訴訟リスクを開発コストとして織り込んでいたのではないか」
「AIは使っているが、海賊版を入手したのであれば話は別」
といった反応もあります。
一方で、音楽出版社側に対しても厳しい見方があり、「巨大音楽会社対巨大AI企業」という構図そのものを冷めた目で見るユーザーも少なくありません。
生成AIの学習自体には肯定的でも、データの調達方法まで無条件に容認するわけではないという反応が興味深いところです。
今回の裁判、本当に重要なのは「学習データの出どころ」
生成AIの著作権ニュースでは、
「AI学習は著作権侵害なのか」
という二択で語られがちです。
しかし実際の裁判は、もっと細かくなっています。
今回を見るだけでも、
合法的に取得した著作物を学習する
ことと、
海賊版を大量にダウンロードする
ことと、
ライセンスされたWebサイトをスクレイピングする
ことと、
学習した作品をほぼそのまま出力する
ことは、それぞれ別の問題です。
Bartz訴訟ではすでに、同じAnthropicに対して「AI学習はフェアユースになり得るが、海賊版の取得は別」という線引きが示されました。
今回の音楽出版社35社による訴訟は、その境界線をさらに具体的に争うものになりそうです。
みらいアンテナの見方:AI企業の競争力が「データ調達」に戻ってきた
これまで生成AIの競争では、
モデルの性能
↓
計算資源
↓
推論コスト
↓
AIエージェント
と、モデル側の技術が注目されてきました。
しかし今回のような訴訟が積み重なるほど、もう一度重要になるのが、
「そのモデルを何で学習させたのか」
です。
大量の高品質データが必要だからといって、取得方法まで自由になるわけではありません。
逆に、出版社やニュース企業などと正式なライセンス契約を結び、学習データの出どころを説明できるAI企業にとっては、それ自体が競争力になる可能性があります。
今後のAI業界ではモデル性能だけでなく、
- データの入手経路
- ライセンスの有無
- 学習データの追跡可能性
- 削除要求への対応
- モデルが著作物をそのまま出力しない仕組み
まで含めて「AIをどう作ったか」が問われるでしょう。
今回の訴訟で裁判所がどこまで音楽出版社側の主張を認めるかはまだ分かりません。
ただ一つ確かなのは、
「ネットにあったから学習できる」という時代から、「どこからどう入手したデータなのか」を説明する時代へ移っている
ということです。
参照した一次情報
発表元:米カリフォルニア州北部地区連邦地裁への提出文書
資料名:Sony Music Publishing (US) LLC et al. v. Anthropic PBC et al. — COMPLAINT AND DEMAND FOR JURY TRIAL
提出日:2026年8月28日
URL:https://www.musicbusinessworldwide.com/files/2026/08/COMPLAINT-in-Sony_Music_Publishing_US_LLC_e.pdf
発表元:米カリフォルニア州北部地区連邦地裁
資料名:Bartz et al v. Anthropic PBC — Order Granting Final Approval of Class Action Settlement
決定日:2026年7月20日
URL:https://law.justia.com/cases/federal/district-courts/california/candce/4%3A2024cv05417/434709/680/