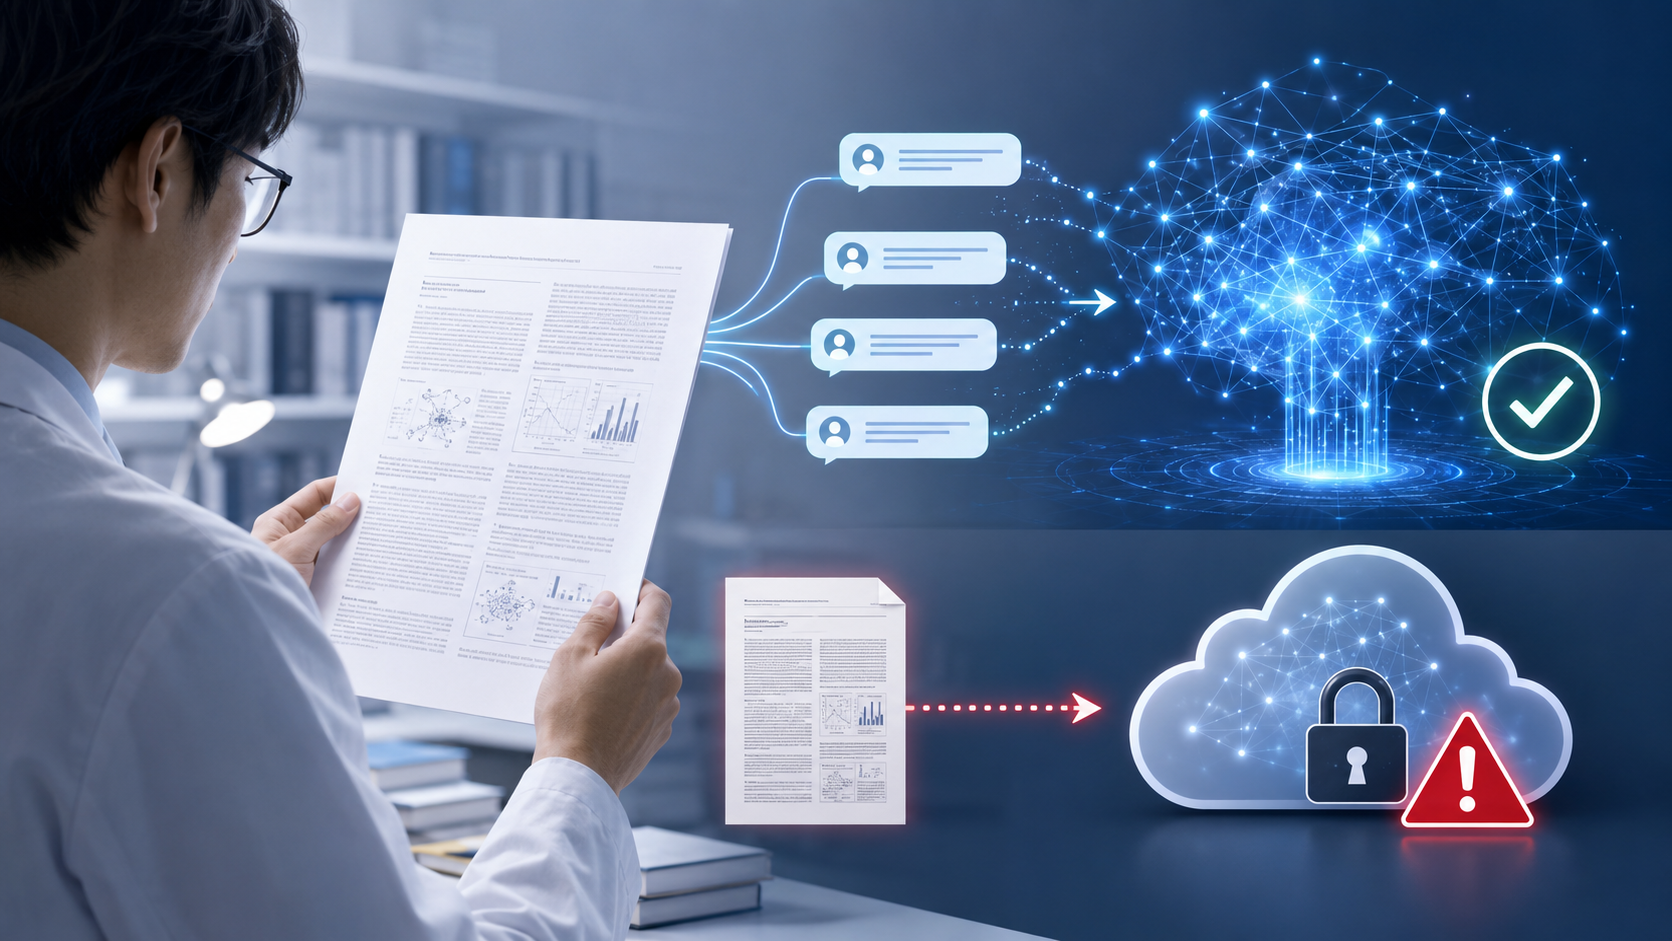
学術論文の「査読」にも、生成AIが入り始めています。
査読とは、研究者が投稿された論文を読み、内容や方法に問題がないかを専門家の立場から確認する仕組みです。
これまでは基本的に人間が時間をかけて行ってきましたが、論文数の増加や研究者の負担を背景に、翻訳、要約、査読コメントの作成などで生成AIを使うケースが増えています。
Frontiersが世界の研究者1645人を対象に行った調査では、査読者の53%がAIを利用した経験があると回答しました。
ただし、便利だからと査読そのものをAIへ任せてしまうと、「存在しない論文を参考文献として提示する」といった問題も起きています。
では、AIは査読に使わない方がいいのでしょうか。
実は、そこまで単純な話でもありません。
査読者の53%がAIを利用、用途は「文章作成」が中心
Frontiersが2025年に実施した調査を見ると、生成AIはすでに査読の一部になりつつあります。
AIを利用したことがある査読者は53%。
具体的な利用方法は、
| 用途 | 利用割合 |
|---|---|
| 査読文の作成 | 59% |
| 論文の要約 | 29% |
| 盗用などの確認 | 28% |
| 方法論・統計の評価 | 19% |
となっています。
興味深いのは、研究の中身を評価するよりも、文章作成や要約といった比較的「表面的な作業」での利用が多いことです。
Wileyの別の調査でも、研究・出版関連業務でAIを利用する研究者は2024年の45%から2025年には62%へ増えています。
研究者にとって生成AIは、すでに特殊なツールではなくなりつつあります。
「架空の参考文献」が査読コメントに登場
一方で、AIに査読を任せたと疑われるケースも出ています。
読売新聞が取材した研究者の一人は、国際学会へ提出した論文について届いた査読コメントの中に、参考文献として論文タイトルと著者名が記載されていたものの、実際に探してもその論文が見つからなかったといいます。
生成AIが、存在しない情報をもっともらしく作る「ハルシネーション」だった可能性があります。
別の研究者も、指摘された内容に従って論文を修正しても、何度も似た抽象的なコメントを返されたとしています。
AIが査読コメントを作ること自体より問題なのは、
人間が出力内容を確認せず、そのまま研究者へ返してしまうこと
です。
査読は論文の採否や研究者のキャリアにも影響する重要なプロセスです。
存在しない文献を根拠に修正を要求されたとすれば、単なるAIの「ちょっとした間違い」では済みません。
実は「ハルシネーション」より情報漏えいの方が厄介
AI査読で見落とされやすいのが、未発表論文の機密性です。
査読中の論文には、
- まだ公表されていない研究成果
- 新しい技術やアイデア
- 未公開データ
- 医学分野なら患者に関する情報
などが含まれる場合があります。
これを一般向けの生成AIサービスへそのまま入力すると、サービス側で保存・処理される可能性があります。
このためWileyは、査読者が投稿論文やその一部を生成AIへアップロードすることを禁止しています。
AIの利用を全面禁止しているわけではありません。
例えば、
- 自分が書いた査読コメントの文章を整える
- 英訳する
- 一般的な研究手法について質問する
といった使い方は可能ですが、査読対象の論文そのものをAIへ渡してはいけないという考え方です。
日本でも環境経済・政策学会は、公開前の論文やその一部を生成AIツールへアップロードしないよう明記しています。
日本広報学会も2026年にAI利用ガイドラインを策定し、機密性の高い査読原稿をクラウド型AIへ入力することを原則認めない方針を示しました。
さらに9月1日にはHealth ISAC Japanが、医学論文における生成AI利用について新たな提言を公開。
正確性だけでなく、機密情報の管理やサイバーセキュリティまで含めて検討すべきだとしています。
一方、AIを「査読者の補助」にすると改善した実験も
では、査読でAIを使うこと自体が問題なのでしょうか。
そうとも言い切れません。
2026年2月にNature Machine Intelligenceで発表された研究では、ICLR 2025の査読2万件以上を使い、「Review Feedback Agent」というAIシステムを実際の査読者へ提供しました。
ポイントは、AIが論文を採点するのではなく、人間が書いた査読コメントに助言する仕組みだったことです。
例えば、
「この指摘は曖昧すぎる」
「具体的な根拠を説明した方がよい」
といったフィードバックをAIが返します。
その結果、AIから助言を受け取った査読者の27%が査読文を修正し、合計1万2000件以上の提案が採用されました。
修正した査読文は平均80語長くなり、第三者による評価でも情報量が多いと判断されています。
つまり、
AIに査読を任せる
のと、
AIに人間の査読をレビューさせる
のでは、かなり意味が違います。
どこまでならAIに任せてもいい?
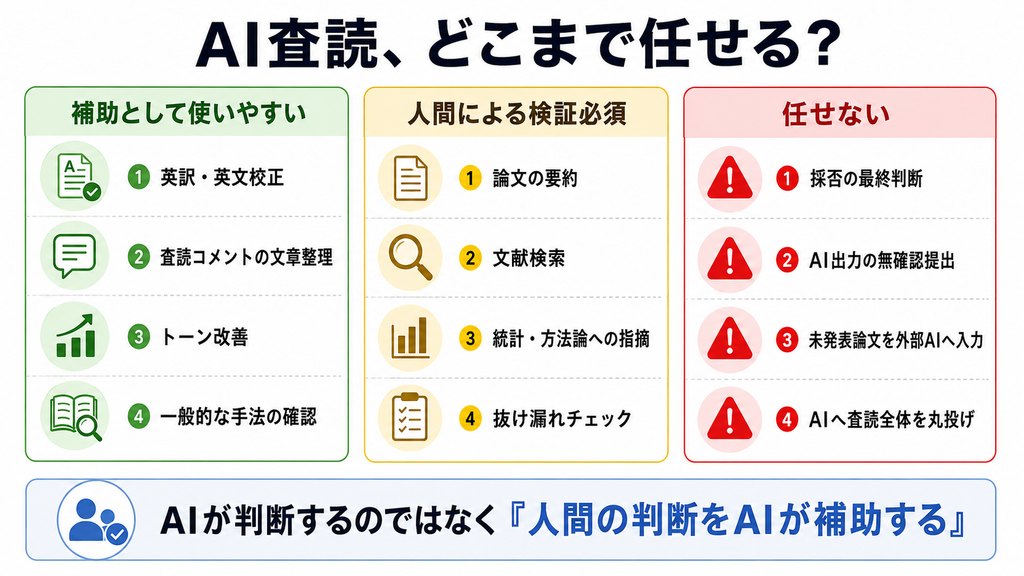
現在の研究や出版社のルールを見ると、おおよその境界線が見えてきます。
比較的使いやすい
- 自分が書いた査読コメントの文章整理
- 英訳・英文校正
- コメントのトーン改善
- 一般的な統計・研究手法の確認
- 抜け漏れチェック
注意が必要
- 論文本文の要約
- 研究内容の評価
- 参考文献の提案
- 統計解析が妥当かの判断
AIへ任せるべきではない
- 採択・不採択の最終判断
- 未発表論文を外部AIへ丸ごと入力
- AIが生成した査読コメントを無確認で提出
- 架空文献を含む可能性がある情報の無検証利用
結局のところ、
「AIが判断する」のではなく、「人間が判断するためにAIを使う」
という線引きが重要になります。
ネットでも「誤情報より機密性が怖い」との指摘
今回のニュースに対するネット上の反応は、現時点では大規模とは言えません。
Redditの関連投稿も数票程度で、国内SNSを含め反応は限定的です。
ただ研究者からは、
「査読にAIを使うなら、架空文献より未発表論文の情報流出の方が重要ではないか」
「AIは情報整理には使えても、研究への『見解』を丸投げするべきではない」
といった指摘が見られます。
AIが間違えること以上に、
本来外へ出してはいけない情報を、便利だからと入力してしまう
ことへの警戒が強いようです。
みらいアンテナの見方:問題は「AI査読」ではなく責任の所在
生成AIのニュースでは、
「AIを使った」
↓
「危険だから禁止」
という議論になりがちです。
しかし査読については、全面禁止が最適とも限りません。
研究論文は増え続け、査読は多くの場合、研究者が本業の合間に無償で行っています。
この負担をAIで少しでも軽くできるメリットは大きいでしょう。
実際、2万件超の査読を使った実験では、人間の査読コメントを改善する用途で効果が確認されています。
問題は、AIを使うかどうかではなく、
「誰が最終的に責任を持つのか」
です。
AIが作った参考文献。
AIが指摘した統計上の問題。
AIが提案した不採択理由。
これらを、
「AIがそう言ったから」
で済ませることはできません。
査読者が検証し、自分の判断として提出する必要があります。
生成AIが研究の世界へ広がるほど、査読でも「人間が全部やる」から「AIと分担する」方向へ進む可能性があります。
そのとき必要なのはAI禁止のルールだけではなく、
機密データを守れる環境、AI利用の開示、そして最終判断を人間に残す設計
なのかもしれません。
参照した一次情報
発表元:Frontiers
資料名:Most peer reviewers now use AI, and publishing policy must keep pace
発表日:2025年12月15日
URL:https://www.frontiersin.org/news/2025/12/15/most-peer-reviewers-now-use-ai-and-publishing-policy-must-keep-pace
発表元:John Wiley & Sons
資料名:Wiley Peer Review Policy
更新確認日:2026年9月2日
URL:https://authors.wiley.com/Reviewers/journal-reviewers/tools-and-resources/review-confidentiality-policy.html
発表元:環境経済・政策学会
資料名:環境経済・政策学会における生成AI利用に関する基本方針
発表日:2024年10月9日
URL:https://www.seeps.org/web/about/ai_policy/
発表元:Nature Machine Intelligence
資料名:A large-scale randomized study of large language model feedback in peer review
発表日:2026年2月23日
URL:https://www.nature.com/articles/s42256-026-01188-x
発表元:Health ISAC Japan
資料名:提言「医学論文における生成AIの安全な利活用に向けた基礎的な検討事項」の公開
発表日:2026年9月1日
URL:https://health-isac-japan.jp/2026/09/01/202609-01/